Ontwikkelaars
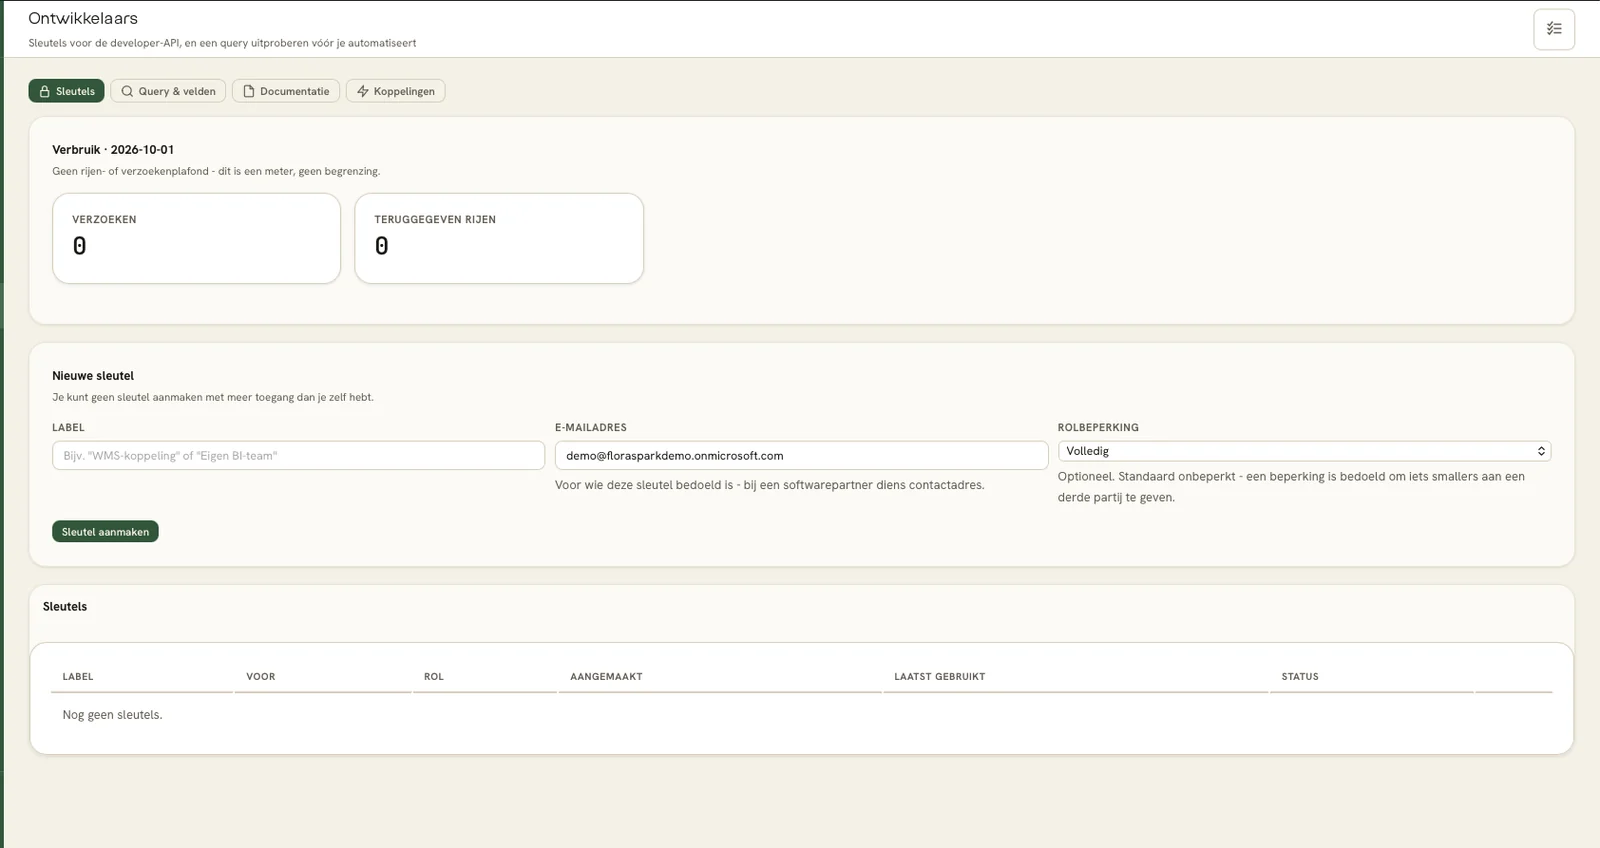
Met Ontwikkelaars koppel je jullie eigen software aan de Suite. Het scherm heeft vier tabbladen: Sleutels voor de developer-API, Query & velden om een query uit te proberen voordat je hem automatiseert, Documentatie met de API-referentie, en Koppelingen om een eigen app aan Spark AI te hangen.
Sleutels
Bovenaan zie je het verbruik van deze maand: het aantal verzoeken en het aantal teruggegeven rijen. Dat is een meter voor de hele organisatie, er zit geen plafond op. Wel geldt er per sleutel een snelheidslimiet: standaard 60 verzoeken per minuut, en 5 per minuut voor vragen in gewone taal. Die vragen gaan bovendien van hetzelfde AI-tegoed af als Spark AI.
Onder Nieuwe sleutel maak je een sleutel aan:
- Label: een naam waaraan je de sleutel herkent, bijvoorbeeld "WMS-koppeling".
- E-mailadres: voor wie de sleutel bedoeld is. Bij een softwarepartner vul je diens contactadres in.
- Rolbeperking: optioneel. Laat je hem leeg, dan is de sleutel onbeperkt. Met een beperking geef je een derde partij minder te zien: Alleen omzet of Alleen inkoop.
Klik op Sleutel aanmaken. De sleutel verschijnt dan één keer, met een knop Kopiëren. Kopieer hem meteen: hij wordt nergens opgeslagen en is daarna niet meer op te vragen.
Ben je geen beheerder en heb je zelf een beperkte rol, dan kun je alleen een sleutel met je eigen rol aanmaken. Voor een andere rol vraag je een beheerder. Onder Sleutels staat elke sleutel met voor wie hij is, de rol, wanneer hij is aangemaakt en laatst gebruikt, en de status.
Query & velden
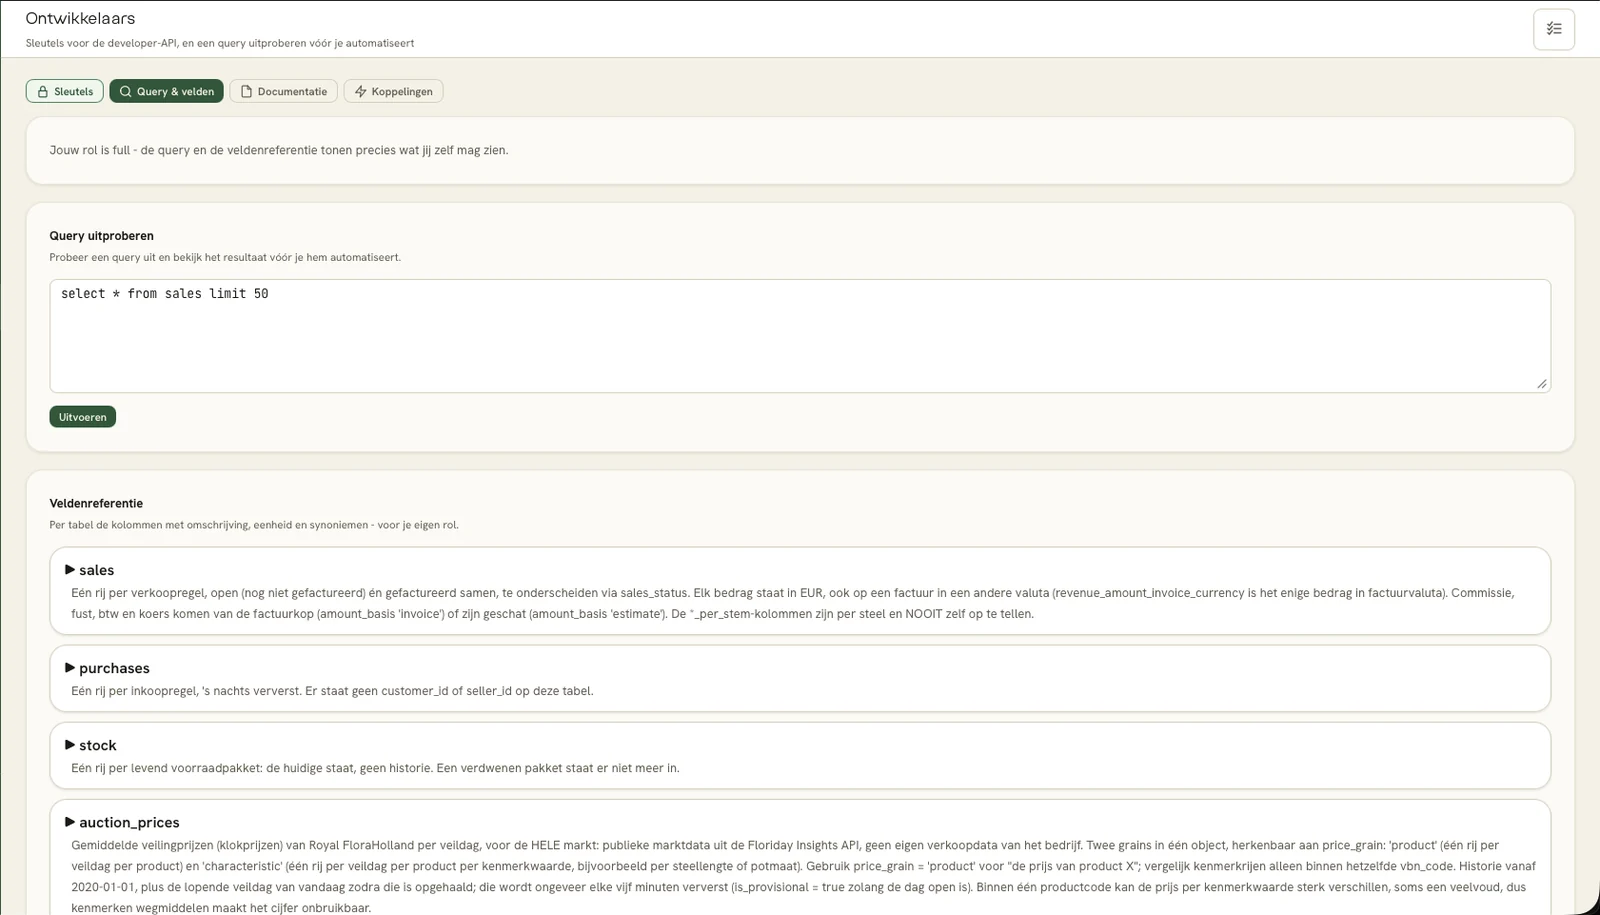
Hier probeer je een query uit voordat je hem in een koppeling zet. Typ een SELECT, bijvoorbeeld select * from sales limit 50, en klik op Uitvoeren. Je ziet precies wat jouw rol mag zien.
Onder Veldenreferentie staat per tabel, zoals sales, purchases, stock en auction_prices, wat erin staat. Klap een tabel open voor de kolommen met hun omschrijving, eenheid en synoniemen.
Documentatie
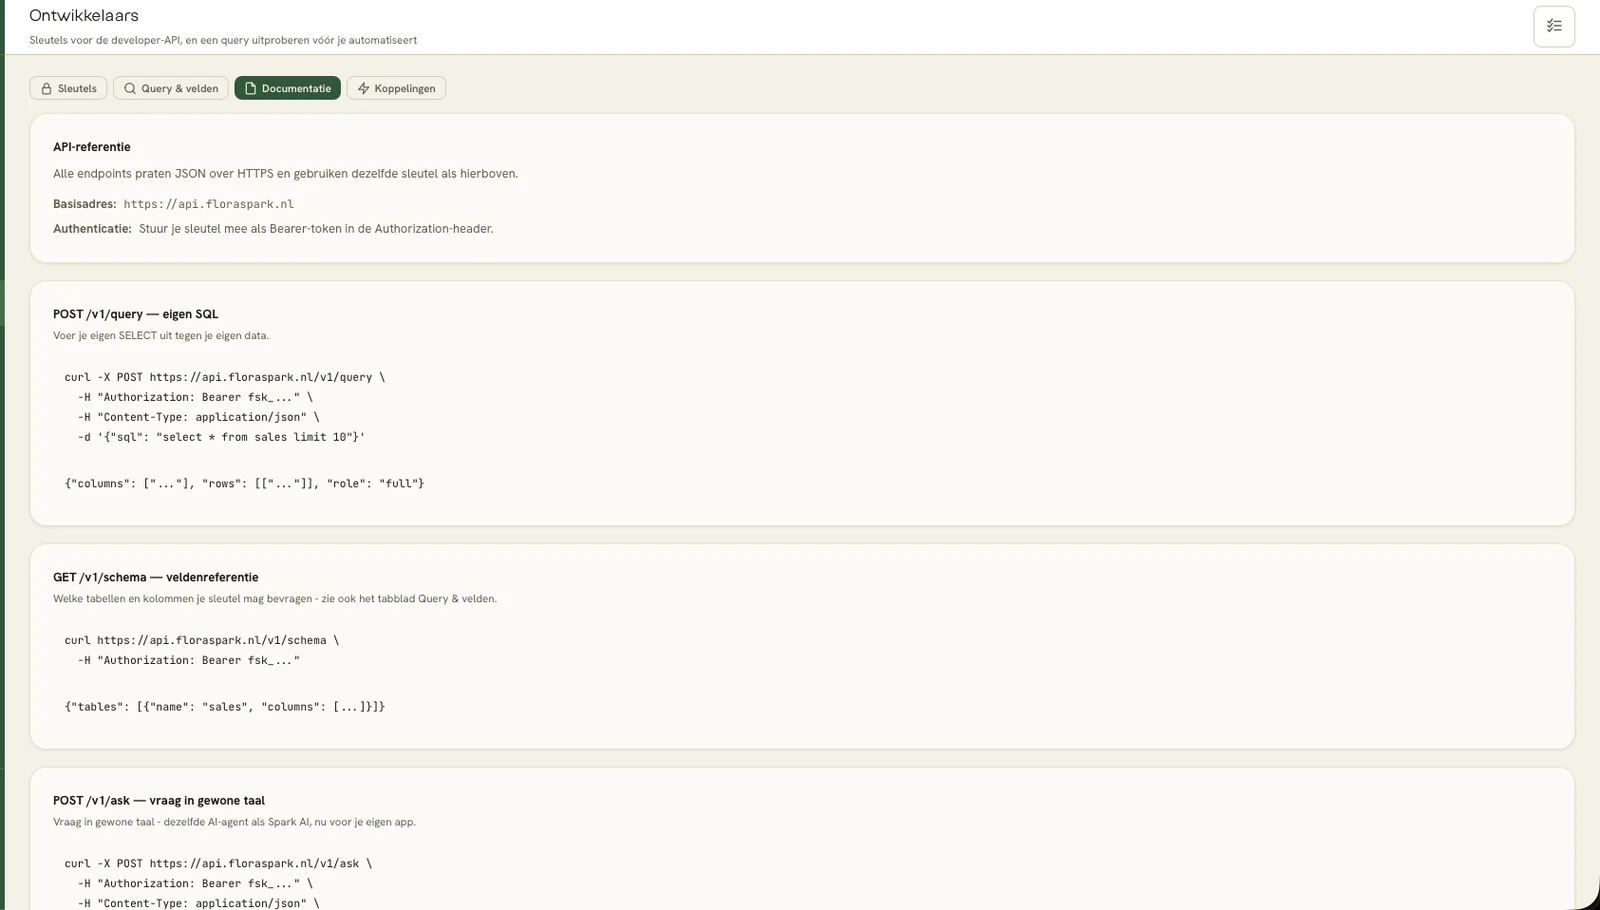
Hier staat de API-referentie met het basisadres en per endpoint een voorbeeld. Het basisadres is https://api.floraspark.nl. Alle endpoints praten JSON over HTTPS en gebruiken dezelfde sleutel. Die stuur je mee als Bearer-token in de Authorization-header. De volledige technische beschrijving, met voorbeeldantwoorden, foutcodes en grenzen, staat hieronder bij API-referentie.
| Endpoint | Wat het doet |
|---|---|
| POST /v1/query (eigen SQL) | Voert je eigen SELECT uit op jullie eigen data |
| GET /v1/schema (veldenreferentie) | Geeft de tabellen en kolommen die je sleutel mag bevragen |
| POST /v1/ask (vraag in gewone taal) | Stelt je vraag aan dezelfde AI-agent als Spark AI, nu vanuit je eigen app |
| POST /v1/reports (rapportmail versturen) | Laat een rapportmail maken en versturen, met een opgeslagen rapport, met blokken of met een eigen opdracht |
| GET /v1/reports/{id} (status van een rapport) | Zegt of het rapport ontvangen, bezig, verstuurd of mislukt is |
| GET /v1/reports/options (keuzes voor een rapport) | Geeft de blokken en opgeslagen rapporten waaruit je kunt kiezen |
Een rapportmail via de API bevat alleen wat je sleutel mag zien en gaat af van het AI-tegoed. Je stuurt hoogstens 20 ontvangers per keer en hoogstens 100 rapporten per dag voor de hele organisatie. Het verzoek krijgt meteen een nummer terug; daarmee vraag je daarna de status op. Verstuurd betekent dat de mail de deur uit is, niet dat hij al in de inbox staat. De gebruiker bij de sleutel heeft de module Rapporten nodig.
Koppelingen
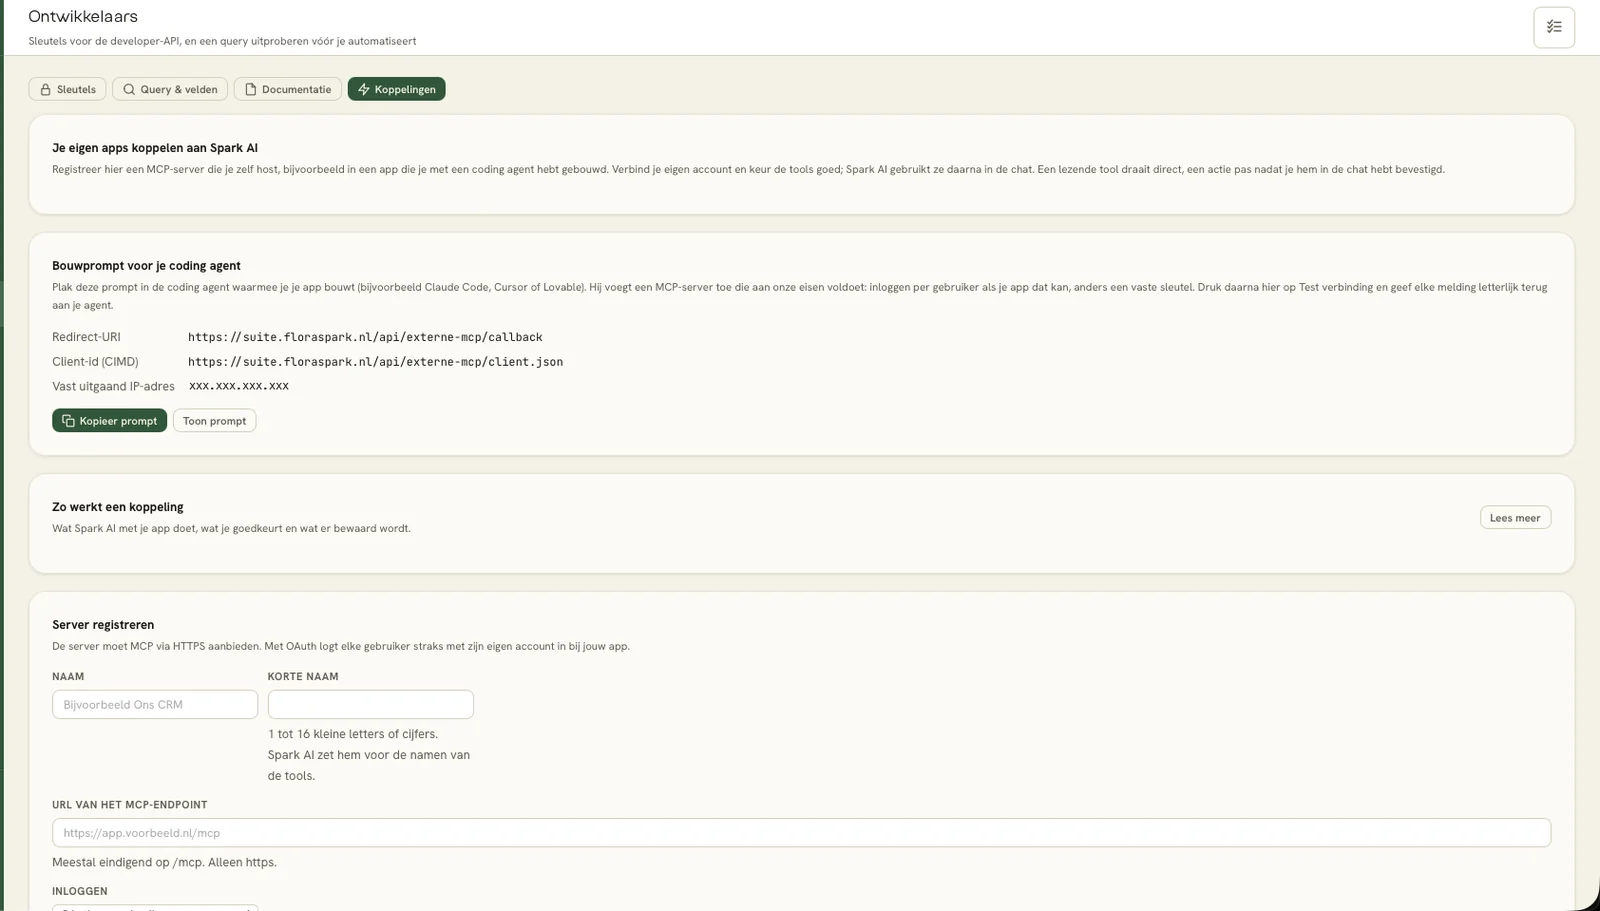
Met Koppelingen hang je een eigen app aan Spark AI, bijvoorbeeld jullie CRM of een tool die je met een coding agent hebt gebouwd. Die app biedt een MCP-server aan, en Spark AI kan de tools daarvan daarna in de chat gebruiken. Een lezende tool draait direct, een actie pas nadat je hem in de chat hebt bevestigd.
Zo leg je een koppeling aan
- Klik bij Bouwprompt voor je coding agent op Kopieer prompt en plak hem in de coding agent waarmee je je app bouwt, bijvoorbeeld Claude Code, Cursor of Lovable. De agent voegt een MCP-server toe die aan onze eisen voldoet. Bij de prompt staan ook de redirect-URI, het client-id en het vaste IP-adres waarvandaan Spark AI je server aanroept. De eisen zelf staan ook op deze pagina, bij MCP-server: technische eisen.
- Vul onder Server registreren een naam in, een korte naam (1 tot 16 kleine letters of cijfers; Spark AI zet hem voor de namen van de tools) en de URL van het MCP-endpoint. Die begint met https en eindigt meestal op /mcp.
- Kies bij Inloggen hoe Spark AI bij je app inlogt (zie hieronder) en klik op Registreren.
- Klik bij de server op Test verbinding. Je ziet per stap wat in orde is en wat niet. Een melding kun je letterlijk aan je coding agent teruggeven.
- Verbind je account met Verbinden en kies bij Tools voor Spark AI welke tools Spark AI mag gebruiken: per tool lezend of actie, en of hij in de chat mag. Sla op met Goedkeuring opslaan.
| Inloggen | Wat het betekent |
|---|---|
| OAuth per gebruiker | Elke collega verbindt zijn eigen account met je app. Spark AI kan daardoor nooit meer dan die persoon zelf, en je app beslist wat dat is |
| Vaste sleutel | Eén sleutel voor iedereen in de rollen die je aanvinkt. Je app ziet dan alleen FloraSpark, niet wie de vraag stelt. Een vaste sleutel stelt alleen een beheerder in |
Tools goedkeuren kan een beheerder of degene die de server registreerde.
Wat je moet weten
- Je keurt elke tool zelf goed. Verandert je app de naam, beschrijving of invoer van een tool, dan verdwijnt hij uit Spark AI tot je hem opnieuw goedkeurt.
- Een actie pas na bevestiging. Wil Spark AI een actie uitvoeren, dan toont de chat de exacte gegevens met Uitvoeren en Weigeren. Er gebeurt niets tot de gebruiker kiest, en een besluit geldt één keer en tien minuten.
- Je server. Hij moet publiek bereikbaar zijn via HTTPS met een geldig certificaat, op poort 443 of een poort vanaf 1024, zonder redirects. Spark AI belt altijd vanaf hetzelfde IP-adres, dus daarop kun je je server afschermen.
- Grenzen. Een aanroep heeft een maximale duur, een resultaat een maximale omvang, en per gebruiker komt er een maximaal aantal tools in Spark AI. De actuele waarden staan onder Zo werkt een koppeling.
- Wat er bewaard wordt. Tokens en sleutels staan versleuteld in een eigen kluis en zijn nergens in te zien. Elke aanroep komt 90 dagen in een logboek: wie, welke tool, de uitkomst en de omvang, en bij een actie ook de gegevens en wie bevestigde.
- Stoppen. Met Verbreken verbreek je je eigen verbinding. Verwijder je de server, dan verdwijnen alle verbindingen, goedkeuringen en sleutels ermee.
API-referentie
Dit deel is voor wie de koppeling bouwt, of voor de coding agent die het voor je doet. Het beschrijft de API zoals hij nu draait. Een interactieve versie staat op api.floraspark.nl/docs, de OpenAPI-specificatie op api.floraspark.nl/openapi.json.
Basisadres en authenticatie
- Basisadres:
https://api.floraspark.nl. Alleen HTTPS. - Sleutel: begint met
fsk_. Stuur hem bij elk verzoek mee alsAuthorization: Bearer <sleutel>, nooit in de URL. - Formaat: verzoeken en antwoorden zijn JSON (
Content-Type: application/json), in UTF-8. - Bereik: een sleutel hoort bij één organisatie en één rol. Je ziet altijd alleen de eigen data van je organisatie, en met een rolbeperking alleen wat die rol mag zien.
Zet de sleutel in een omgevingsvariabele, bijvoorbeeld FLORASPARK_API_KEY, en niet in je code of in git.
curl https://api.floraspark.nl/v1/schema \
  -H "Authorization: Bearer $FLORASPARK_API_KEY"
Fouten
Elke fout heeft dezelfde vorm: een JSON-object met error, een leesbare zin in het Nederlands. Bij fouten waar je op kunt sturen staat er ook een code bij.
{ "error": "Snelheidslimiet bereikt voor deze sleutel." }| Status | Betekenis | Wat je doet |
|---|---|---|
| 400 | Het verzoek klopt niet: ongeldige JSON, een ontbrekend veld, of een query die niet mag | Lees error, pas het verzoek aan. Niet opnieuw proberen zonder wijziging |
| 401 | Geen, een ongeldige of een ingetrokken sleutel | Controleer de header en de sleutel |
| 402 | ai_budget_exhausted: het AI-tegoed van deze maand is op (alleen bij /v1/ask en rapporten) | Wachten tot volgende maand, of het tegoed laten ophogen |
| 403 | De sleutel mag dit niet, bijvoorbeeld geen_rapporten | Vraag een beheerder de module of rol aan te passen |
| 404 | Niet gevonden, of een functie die voor jullie niet aanstaat (ask_disabled, reports_disabled) | Controleer het pad of de id |
| 422 | De inhoud van een vraag of rapport klopt niet, bijvoorbeeld te veel ontvangers | Lees error, pas het verzoek aan |
| 429 | Te veel verzoeken: de minuutlimiet van de sleutel, te veel mislukte pogingen vanaf je IP-adres, of daglimiet_bereikt bij rapporten | Wacht en probeer het later opnieuw, liefst met oplopende wachttijd |
| 502 | Een storing aan onze kant of een query die te lang duurde | Later opnieuw proberen |
Snelheidslimieten
| Wat | Grens |
|---|---|
Verzoeken per sleutel (/v1/query, /v1/schema, rapportstatus en -opties) | 60 per minuut |
Vragen in gewone taal (/v1/ask) | 5 per minuut per sleutel |
Rapporten aanvragen (POST /v1/reports) | 5 per minuut per sleutel, en 100 per dag voor de hele organisatie |
| Mislukte pogingen met een ongeldige sleutel | 20 per minuut per IP-adres, daarna een minuut geblokkeerd (Retry-After: 60) |
Het venster is een vaste minuut. Krijg je een 429, wacht dan tot de minuut om is. Er zit geen plafond op het totale aantal verzoeken of rijen per maand; dat is alleen een meter.
POST /v1/query
Voert één SELECT uit op jullie data en geeft de kolommen en rijen terug.
curl https://api.floraspark.nl/v1/query \
  -H "Authorization: Bearer $FLORASPARK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"sql": "select sales_iso_week, sum(revenue_amount) as omzet from sales where sales_iso_year = 2026 and is_revenue_line group by 1 order by 1"}'
Antwoord (200):
{
  "columns": ["sales_iso_week", "omzet"],
  "rows": [[1, 48210.55], [2, 51377.10]],
  "role": "full"
}rowsis een lijst van lijsten, in de volgorde vancolumns. Datums en tijdstippen komen als tekst (ISO 8601), bedragen als getal.roleis de rol waarmee de query draaide:full,revenue_onlyofpurchase_only.
Regels voor de query:
- Precies één statement, en alleen
SELECTofWITH ... SELECT. Geen INSERT, UPDATE, DELETE of andere wijzigingen, ook niet in een CTE. - Gebruik alleen de tabellen uit
GET /v1/schema, zonder schemaprefix:from sales. CTE-namen uit dezelfde query mogen ook. Elke andere tabel wordt geweigerd. - Systeemtabellen (
pg_catalog,information_schema), functies met een schemaprefix en functies die namen of rechten opzoeken (pg_*,to_reg*,has_*_privilege, casts naarregclass) worden geweigerd. - Een query mag hoogstens 3500 rijen opleveren. Komen er meer, dan krijg je een 400 en geen afgekapt resultaat. Tel en groepeer dus in SQL (
sum,count,group by), of haal in stukken op met een filter op datum of id. - Een query mag hoogstens 30 seconden duren.
Een geweigerde query krijgt een 400 met de reden in error. Die tekst is bedoeld om je query mee te verbeteren.
GET /v1/schema
Geeft de tabellen en kolommen die je sleutel mag bevragen. Dit is dezelfde lijst als onder Query & velden, en de enige bron die telt: hij past zich aan de rol van de sleutel en de modules van je organisatie aan.
{
  "schema": "...",
  "data_role": "full",
  "tables": [
    {
      "name": "sales",
      "description": "...",
      "grain": "Eén rij per verkoopregel (sales_line_key), open of gefactureerd.",
      "columns": [
        { "name": "revenue_amount", "description": "...", "unit": "EUR", "aggregatable": true }
      ]
    }
  ]
}
Lees de description van een kolom voordat je hem gebruikt: daar staat wat je wel en niet kunt optellen. Bij sommige kolommen staan ook synonyms. Gebruik name uit tables in je query; het veld schema heb je niet nodig.
De tabellen
| Tabel | Eén rij per | Zichtbaar voor |
|---|---|---|
| sales | Verkoopregel, open of gefactureerd (sales_line_key) | Alle rollen; bedragen alleen bij full en revenue_only |
| purchases | Inkoopregel (line_id) | full en purchase_only |
| stock | Voorraadpakket dat er nu ligt (parcel_key) | Alle rollen; kostprijs alleen bij full en purchase_only |
| auction_prices | Veildag, kanaal, locatie en product, eventueel per kenmerk | Alleen met de module Veilingprijzen |
| auction_prices_intraday | Waarneming van een prijsreeks tijdens de veildag | Alleen met de module Veilingprijzen |
Kolommen die per rol verschillen: margin_amount en commission_amount alleen bij full; omzetbedragen (revenue_amount, revenue_per_stem) bij full en revenue_only; inkoopbedragen (cost_amount, cost_per_stem) bij full en purchase_only. Wat je sleutel niet mag zien, bestaat voor hem niet: de kolom staat niet in het schema en een query erop wordt geweigerd.
Goed om te weten bij het ophalen:
- Omzet tellen. Filter op
is_revenue_lineals je omzet wilt optellen; gebruiksales_dateals de datum van een verkoop. Prijzen per steel (revenue_per_stem,cost_per_stem) tel je nooit op: gebruik de bedragkolommen. - Verversen. De data komt elke 15 minuten opnieuw binnen. Vaker ophalen levert niets nieuws op.
- Incrementeel ophalen kan op
version. Bijsalesalleen samen metsales_status, want open en gefactureerde regels hebben elk hun eigen reeks. Bijpurchasesenstockgeldt dat niet. - Verwijderingen zie je niet. Verdwijnt een regel uit de bron, dan valt hij weg uit de tabel. Wie alleen incrementeel ophaalt, merkt dat nooit. Haal daarom af en toe alles opnieuw op.
- Veilingprijzen. Kies in
auction_pricesaltijd precies éénprice_grain(productofcharacteristic), anders tel je dubbel.vbn_product_codeis hetzelfde nummer alsarticle_idinsalesenpurchases.
POST /v1/ask
Stelt een vraag in gewone taal aan dezelfde AI-agent als Spark AI. Eén vraag, één antwoord: er is geen gesprekshistorie.
curl https://api.floraspark.nl/v1/ask \
  -H "Authorization: Bearer $FLORASPARK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"question": "Wat was de omzet per week in september?"}'
Antwoord (200):
{
  "answer": "In september was de omzet ...",
  "status": "answered",
  "sql": "select ...",
  "columns": ["week", "omzet"],
  "rows": [[36, 50120.0], [37, 49875.4]]
}answeris de tekst van het antwoord.sql,columnsenrowszijn de laatste query die de agent daarvoor draaide, ofnullals hij geen query nodig had.statusisansweredbij een gewoon antwoord. Een andere waarde betekent dat er geen volledig antwoord is.- De vraag mag hoogstens 8000 tekens zijn. Een antwoord kan een halve minuut duren; zet de timeout van je client ruim.
- Elke vraag gaat van het AI-tegoed af, net als in Spark AI. Gebruik voor vaste koppelingen liever
/v1/query: sneller, voorspelbaar en zonder tegoed.
POST /v1/reports
Laat een rapportmail maken en versturen. Kies één van drie soorten inhoud:
template_id: een opgeslagen rapport uit de Suite. Ontvangers en onderwerp komen dan uit dat rapport, tenzij je ze meestuurt.blocks: een lijst metblock_id's, eventueel met een extrainstruction.instruction: alleen een eigen opdracht in gewone taal.
template_id gaat niet samen met blocks of instruction.
| Veld | Type | |
|---|---|---|
template_id | tekst | Een opgeslagen rapport, zie /v1/reports/options |
blocks | lijst met tekst | block_id's, zie /v1/reports/options |
instruction | tekst | Een eigen opdracht, hoogstens 8000 tekens |
recipients | lijst met tekst, of één tekst met komma's | Hoogstens 20 adressen |
subject | tekst | Optioneel; anders het onderwerp of de naam van het rapport |
curl https://api.floraspark.nl/v1/reports \
  -H "Authorization: Bearer $FLORASPARK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"blocks": ["..."], "recipients": ["inkoop@voorbeeldbedrijf.nl"], "subject": "Weekoverzicht"}'
Het verzoek wordt meteen aangenomen (202) en daarna op de achtergrond gemaakt en verstuurd:
{ "request_id": "3f2c...", "status": "ontvangen" }Fouten die je meteen terugkrijgt: 402 ai_budget_exhausted, 403 geen_rapporten (de gebruiker bij de sleutel heeft de module Rapporten niet), 404 template_not_found, 422 bij geen inhoud, geen of te veel ontvangers, en 429 daglimiet_bereikt (100 per dag per organisatie, in Nederlandse tijd; mislukte verzoeken tellen mee).
GET /v1/reports/{id}
De status van een rapport dat je met dezelfde sleutel hebt aangevraagd. Een verzoek van een andere sleutel geeft een 404.
{
  "request_id": "3f2c...",
  "status": "verstuurd",
  "foutcode": null,
  "fout": null,
  "recipients": ["inkoop@voorbeeldbedrijf.nl"],
  "subject": "Weekoverzicht",
  "created_at": "2026-10-16T08:00:01+00:00",
  "started_at": "2026-10-16T08:00:02+00:00",
  "finished_at": "2026-10-16T08:00:41+00:00"
}statusisontvangen,bezig,verstuurdofmislukt. Vraag de status op met een pauze van een paar seconden ertussen, en stop bijverstuurdofmislukt.- Verstuurd betekent dat de mail de deur uit is, niet dat hij in de inbox staat.
- Bij
misluktstaat er eenfoutcode:model_fout,mail_fout,onderbrokenofonbekend. Het rapport is dan niet verstuurd; vraag het opnieuw aan. Een verzoek dat na 30 minuten nog niet klaar is, krijgtonderbroken.
GET /v1/reports/options
De blokken en opgeslagen rapporten waaruit je kunt kiezen, zoals de gebruiker bij de sleutel ze in de Suite ziet.
{
  "blocks": [
    { "block_id": "...", "label": "...", "description": "..." }
  ],
  "templates": [
    { "template_id": "...", "name": "...", "blocks": ["..."], "recipients": "...", "subject": "..." }
  ]
}
Veranderingen
Tabel- en kolomnamen zijn een belofte: de API leest uit een vaste laag die los staat van onze interne opbouw. Moet er toch iets wegvallen of anders gaan heten, dan kondigen we dat vooraf aan bij het e-mailadres waarvoor de sleutel is aangemaakt. Lees nieuwe kolommen daarom op naam en niet op positie, en negeer velden die je niet kent.
MCP-server: technische eisen
Dit zijn de eisen waaraan je MCP-server moet voldoen om onder Koppelingen te werken. De bouwprompt in de Suite bevat dezelfde eisen, aangevuld met de waarden voor jullie omgeving: de redirect-URI, het client-id en het vaste IP-adres.
Het endpoint
- MCP via Streamable HTTP, meestal op het pad
/mcp. Gebruik de officiële MCP-SDK voor je taal. - Publiek bereikbaar via HTTPS met een geldig certificaat, op poort 443 of een poort vanaf 1024. Private, interne en link-local adressen worden geweigerd.
- Geen redirects op het endpoint en op de metadata-adressen: die worden niet gevolgd.
- Een verzoek zonder geldige inlog of sleutel krijgt HTTP 401, ook voor
initialize.
Inloggen met OAuth per gebruiker
Volgt de autorisatie-eisen van de MCP-specificatie (versie 2026-07-28):
- De 401 draagt
WWW-Authenticate: Bearer resource_metadata="https://<je app>/.well-known/oauth-protected-resource". - Protected Resource Metadata (RFC 9728) op
/.well-known/oauth-protected-resource, metresourceexact gelijk aan de URL van het MCP-endpoint,authorization_serversenscopes_supported. - Authorization Server Metadata (RFC 8414 of OpenID Connect Discovery) met
issuer,authorization_endpoint,token_endpoint,code_challenge_methods_supported: ["S256"]enauthorization_response_iss_parameter_supported: true. Eenrevocation_endpoint(RFC 7009) is welkom: dan trekken we het token in als iemand de verbinding verbreekt. - Clientregistratie, bij voorkeur via een Client ID Metadata Document (
client_id_metadata_document_supported: true); anders Dynamic Client Registration (RFC 7591); anders registreer je FloraSpark met de hand als public client en vul je het client-id in de Suite in. - Authorization code met PKCE S256, verplicht; de methode
plainwordt niet geaccepteerd. issin de autorisatierespons (RFC 9207), naastcodeenstate.- Audience-binding (RFC 8707): we sturen
resourcemee; geef een token uit voor precies die resource en weiger tokens voor een andere. - Refresh-tokens via
grant_type=refresh_token. Roteren mag. - Rechten per tool: elke tool past de rechten toe van de gebruiker van het token, net als in je eigen app.
Inloggen met een vaste sleutel
- De sleutel staat in een omgevingsvariabele van je app, nooit in code of git.
- Standaard komt hij binnen als
Authorization: Bearer <sleutel>; een eigen header mag ook. Vergelijk in constante tijd en geef 401 bij een ontbrekende of verkeerde sleutel. - Gebruik minstens 32 willekeurige tekens: letters, cijfers,
-en_. Een beheerder vult hem in de Suite in. - Je server ziet geen gebruiker, alleen FloraSpark.
Tools en resultaten
| Wat | Grens |
|---|---|
| Toolnaam | Kleine letters, cijfers en _, hoogstens 40 tekens |
| Beschrijving | Hoogstens 950 tekens; langer wordt afgekapt |
Invoerschema (inputSchema) | type: object, hoogstens 8192 bytes; groter en de tool verschijnt niet |
| Tools per gebruiker in Spark AI | Hoogstens 20 |
| Duur van een aanroep | Hoogstens 20 seconden |
| Omvang van een resultaat | Hoogstens 20.000 tekens; langer wordt afgekapt |
- Geef elk invoerveld een
descriptionmet formaat en voorbeeld, zet verplichte velden inrequired, en gebruikenum,minimum,maximumenformatwaar het kan. Spark AI weet van een argument alleen wat in het schema staat. - Zet
readOnlyHint: trueop een tool die alleen leest, endestructiveHint: trueop een tool die iets verwijdert of overschrijft. Dat is een voorstel; de goedkeuring in de Suite beslist. - Pagineer lange lijsten met een invoerveld voor de pagina of een cursor.
- Een fout is een resultaat met
isError: trueen een leesbare zin die het veld en de juiste vorm noemt, geen stacktrace. - Zet nooit geheimen of instructies voor de AI in een resultaat. Alles wat een tool teruggeeft, wordt als gegevens behandeld.
- Houd naam, beschrijving en schema stabiel: elke wijziging haalt de tool uit Spark AI tot hij opnieuw is goedgekeurd.